검색창에 뭔가를 넣고 링크 열 개를 여는 일이 하루에 몇 번씩 있다. 그중 쓸 만한 건 두세 개고 나머지는 닫는다. Perplexity를 쓰기 시작한 건 그 «여는 일»이 귀찮아서였다.
써 보니 «구글의 대체제»는 아니었다. 대신 어떤 질문에서는 확실히 더 낫고, 어떤 질문에서는 확실히 못하다. 그 경계가 어디인지가 이 글의 내용이다. 기능을 하나씩 훑는 대신 구글과 갈리는 지점만 붙들었다.
핵심만 먼저
- 구글은 어디를 볼지 알려 주고, 이쪽은 읽고 나서 답한다
- 가장 큰 차이는 답변 자체가 아니라 출처가 답 안에 번호로 박혀 있다는 것
- 어디서 찾을지(웹·학술·소셜·금융)를 내가 먼저 정할 수 있다
- 그래도 틀린다. 옮겨 적을 값은 출처 원문을 열어야 한다
구글은 찾아 주고, 이쪽은 읽고 답한다
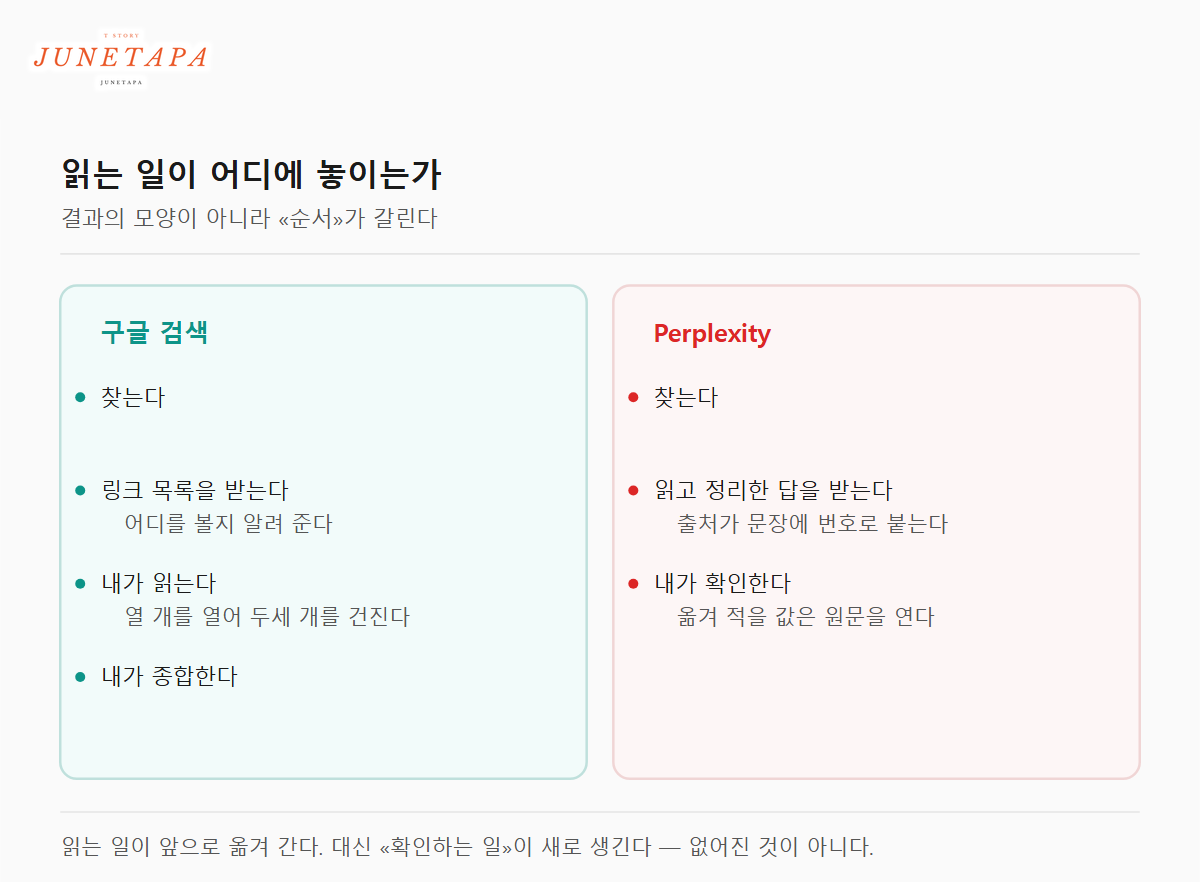
Perplexity는 스스로를 «답변 엔진»이라고 부른다. 말장난 같지만 결과 화면을 보면 무슨 뜻인지 바로 안다. 구글이 링크 목록을 주는 자리에, 이쪽은 정리된 답을 준다.
그래서 쓰는 방식이 달라진다. 구글에서는 결과를 받고 나서 «읽는 일»이 남는데, 여기서는 그 읽는 일을 먼저 끝내고 결과를 준다. 대신 읽는 주체가 내가 아니라는 것이 뒤에서 문제가 된다. 그 얘기는 아래에서 한다.
이어서 묻는 방식도 다르다. 구글은 궁금한 게 더 생기면 검색어를 다시 짠다. 이쪽은 대화가 이어진다. 「방금 그거 초보자 기준으로 다시」라고 하면 앞의 맥락을 물고 다시 답한다. 검색어를 다시 고민하지 않아도 되는 것이 생각보다 크다.
출처가 답 안에 박혀 있다
이게 실제로 쓰면서 가장 크게 느낀 차이다. 답변 문장 옆에 번호가 붙고, 그 번호가 출처로 연결된다. 「어디서 나온 얘기냐」를 되묻지 않아도 된다.
AI가 그럴듯한 말을 지어내는 것이 늘 걱정인데, 출처가 문장 단위로 붙어 있으면 의심할 자리를 바로 찍을 수 있다. 답 전체를 믿거나 안 믿거나 둘 중 하나가 아니라, 「이 문장만 확인해 보자」가 된다.
| 항목 | 구글 검색 | Perplexity |
|---|---|---|
| 결과 모양 | 링크 목록 | 요약된 답 + 출처 |
| 후속 질문 | 검색어를 다시 짠다 | 대화로 이어진다 |
| 복잡한 질문 | 링크를 열어 직접 종합 | 모아서 정리해 준다 |
| 출처 확인 | 내가 고른 링크 | 문장에 번호로 붙는다 |
| 광고 | 상단에 붙는다 | 없다 |
어디서 찾을지 정하고, 여러 번 돌린다
구글에서 검색 범위를 좁히려면 연산자를 외워야 한다. 여기서는 질문을 던질 때 출처 범위를 골라 놓고 시작한다. 웹 전체가 기본이고, 학술 자료만, 커뮤니티 글만, 금융 데이터만 같은 식으로 바꿀 수 있다. PDF나 URL을 직접 붙여 그 안에서만 답하게 할 수도 있다.
이게 왜 중요하냐면, 답의 성격이 통째로 달라지기 때문이다. 같은 질문을 「학술」로 물으면 논문 기준의 답이 오고, 「소셜」로 물으면 실제로 써 본 사람들의 불평이 온다. 어떤 날은 뒤쪽이 더 쓸모 있다.
이렇게 해 보자
키워드를 던지지 말고 문장으로 묻는다. 「Next.js 성능 최적화」보다 「App Router 프로젝트에서 초기 로딩을 줄이는 방법을 이미지 최적화와 캐싱 위주로 알려 줘」가 훨씬 나은 답을 받는다. 구글에서 쓰던 습관이 여기서는 오히려 손해다.
한 번 묻고 끝이 아니다
기본 검색은 빠르게 한 번 찾고 답한다. 그런데 검색을 여러 단계로 쪼개 도는 모드가 따로 있다. 한 번의 결과를 보고 다음 검색어를 스스로 만들어 다시 찾는 식이다.
더 나아간 것이 자동 리서치다. 질문 하나를 두고 수십 차례 검색하며 출처를 읽고, 서로 어긋나는 대목을 짚어 가며 인용이 달린 보고서를 만든다. 한 번 돌리는 데 몇 분이 걸린다. 「사람이 반나절 걸릴 조사」를 맡길 때 쓰는 물건이다.
답을 만드는 모델을 고를 수 있다는 것도 다른 검색과 갈리는 지점이다. 검색에 맞춰 만든 자체 모델이 기본이고, 필요하면 다른 회사의 모델로 바꿔 같은 질문을 다시 던질 수 있다. 같은 질문에 다른 모델을 물려 보면 답이 갈리는 대목이 드러난다 — 그 대목이 대개 확인이 필요한 자리다.
기능 하나하나의 쓰임과 요금 구간까지 자세히 본 정리는 junetapa.com의 Perplexity 완전 정복 가이드에 따로 적어 두었다.
그래도 틀린다
출처가 붙어 있다고 답이 맞는 것은 아니다. 출처는 진짜인데 그 내용을 잘못 요약하는 경우가 있다. 링크가 달려 있으니 더 믿게 되는데, 오히려 그래서 위험하다.
몇 번 겪고 나서 습관을 하나 만들었다. 글에 옮겨 적을 값은 반드시 출처를 연다. 숫자, 날짜, 조건이 붙은 문장이 특히 그렇다. 나머지 서술은 방향을 잡는 용도로만 쓴다.
이건 확인하고
- 논문·공식 문서를 인용할 때는 요약을 쓰지 않는다. 원문을 열어 읽고 인용한다
- 요약 과정에서 조건이 떨어져 나간다. 「특정 조건에서」가 빠지면 문장이 통째로 다른 말이 된다
- 최신 정보라고 해서 정확한 정보는 아니다. 빠르게 도는 얘기일수록 출처가 서로 어긋난다
언제 구글이 낫고 언제 이쪽이 나은가
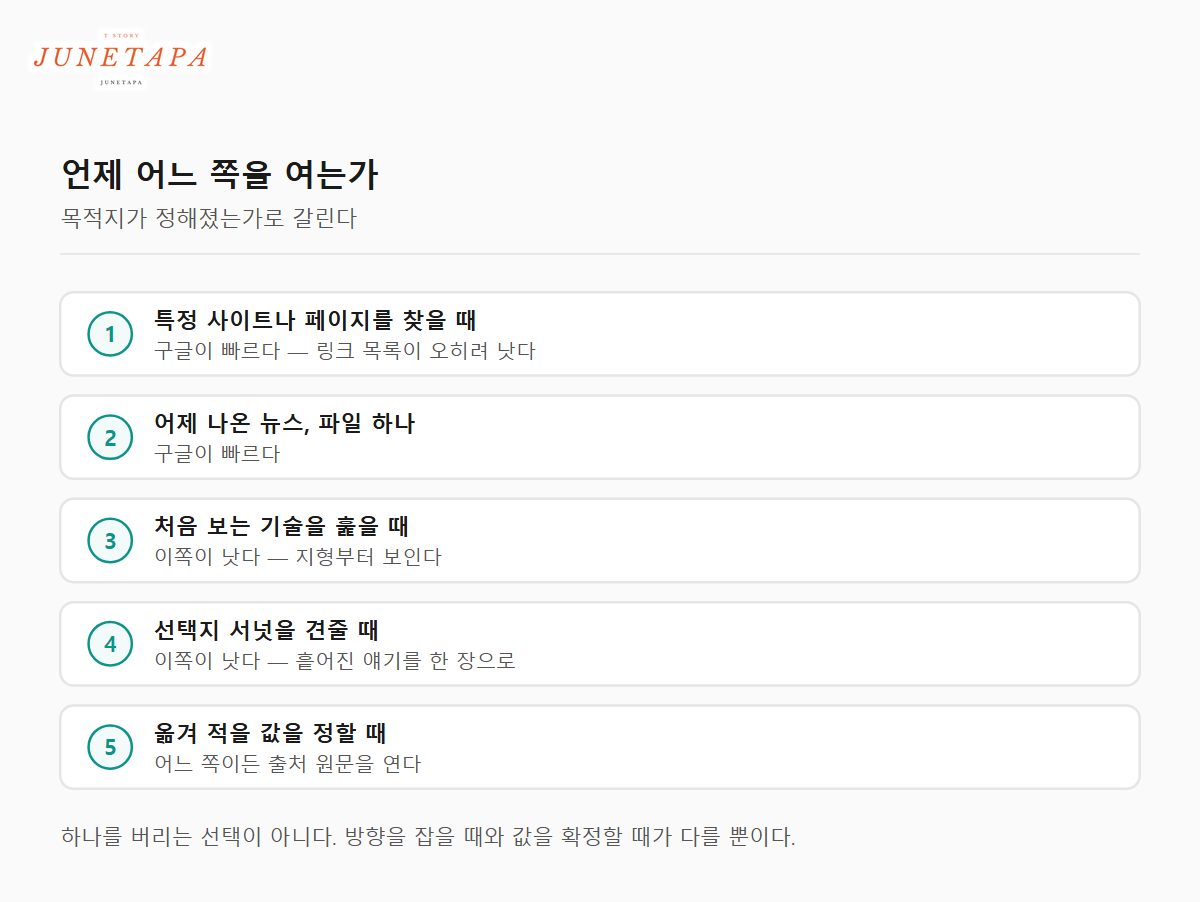
쓰다 보니 경계가 꽤 또렷해졌다. 「무엇인지 알고 찾는 것」은 구글이 빠르다. 특정 사이트, 특정 페이지, 어제 나온 뉴스, 파일 하나. 목적지가 정해진 검색은 링크 목록이 오히려 낫다.
반대로 「뭘 모르는지도 모를 때」는 이쪽이 낫다. 처음 보는 기술을 훑을 때, 선택지 서넛을 견줄 때, 흩어진 얘기를 한 장으로 모을 때. 링크 열 개를 열어 읽던 일이 한 번의 질문으로 줄어든다.
그래서 지금은 둘을 번갈아 쓴다. 방향을 잡을 때 이쪽으로 물어 지형을 보고, 옮겨 적을 값이 생기면 구글로 원문을 찾아 확인한다. 하나를 버리는 선택이 아니었다.

자주 묻는 질문
무료로 쓸 만한가요?
기본 검색은 제한 없이 됩니다. 여러 단계로 도는 정밀 검색은 하루 횟수 제한이 있고, 모델을 골라 쓰는 기능과 산출물 생성은 유료 구간입니다. 리서치를 매일 하는 게 아니라면 무료로 한동안 써 보고 정해도 됩니다.
ChatGPT와는 뭐가 다른가요?
가장 큰 차이는 웹을 먼저 찾고 답한다는 것과 출처가 문장에 붙는다는 것입니다. 글을 짓거나 코드를 짜는 일은 그쪽이 낫고, 「지금 무슨 얘기가 나와 있나」를 찾는 일은 이쪽이 낫습니다.
출처가 있으면 그대로 인용해도 되나요?
안 됩니다. 출처는 어디를 열어 볼지 알려 주는 표지지 인용 근거가 아닙니다. 요약 과정에서 조건이나 뉘앙스가 떨어져 나가는 일이 실제로 있습니다. 옮겨 적을 값은 원문을 여세요.
검색 결과가 마음에 안 들면요?
다시 검색어를 짜지 말고 이어서 지시하세요. 「더 구체적으로」, 「초보자 기준으로 다시」, 「표로 정리해서」처럼 붙이면 맥락을 물고 다시 답합니다. 이 반복이 이 도구의 본체에 가깝습니다.
구글을 안 써도 되나요?
그렇지는 않습니다. 목적지가 정해진 검색은 여전히 구글이 빠릅니다. 둘을 번갈아 쓰는 쪽이 실제로는 가장 편했습니다.
정리하면
Perplexity를 «더 똑똑한 구글»로 소개하는 글이 많은데, 써 보니 그 표현은 어긋난다. 하는 일이 다르다. 구글은 어디를 볼지 알려 주고, 이쪽은 읽고 나서 답한다. 그래서 잘하는 질문의 모양이 서로 다르다.
그리고 답이 정리돼 나온다는 것은 확인할 일이 없어졌다는 뜻이 아니다. 오히려 그럴듯해 보이니 더 확인해야 한다. 이 한 가지만 지키면 링크 열 개를 여는 시간을 꽤 아낄 수 있다.
기능별 쓰임, 모델 선택 기준, 요금 구간까지 더 들어간 정리는 junetapa.com 원문에 있습니다.
'풀스택 개발이야기' 카테고리의 다른 글
| Node.js와 Bun, 실제로 얼마나 차이 나나 — 벤치마크와 내 서비스가 갈리는 지점 (1) | 2026.09.02 |
|---|---|
| GitHub Copilot과 Cursor, 무엇을 고를까 — 기능표보다 먼저 볼 것 (0) | 2026.09.01 |
| Claude API 파이썬 입문 — Anthropic SDK로 첫 호출까지 (0) | 2026.08.28 |
| 로컬에서 도는 AI 에이전트 — 모델이 돌아가는 것과 «맡기는 것»은 다르다 (0) | 2026.08.26 |
| ChatGPT로 유튜브 롱폼 대본 쓰기 — 쇼츠와 다른 점 (0) | 2026.08.24 |


