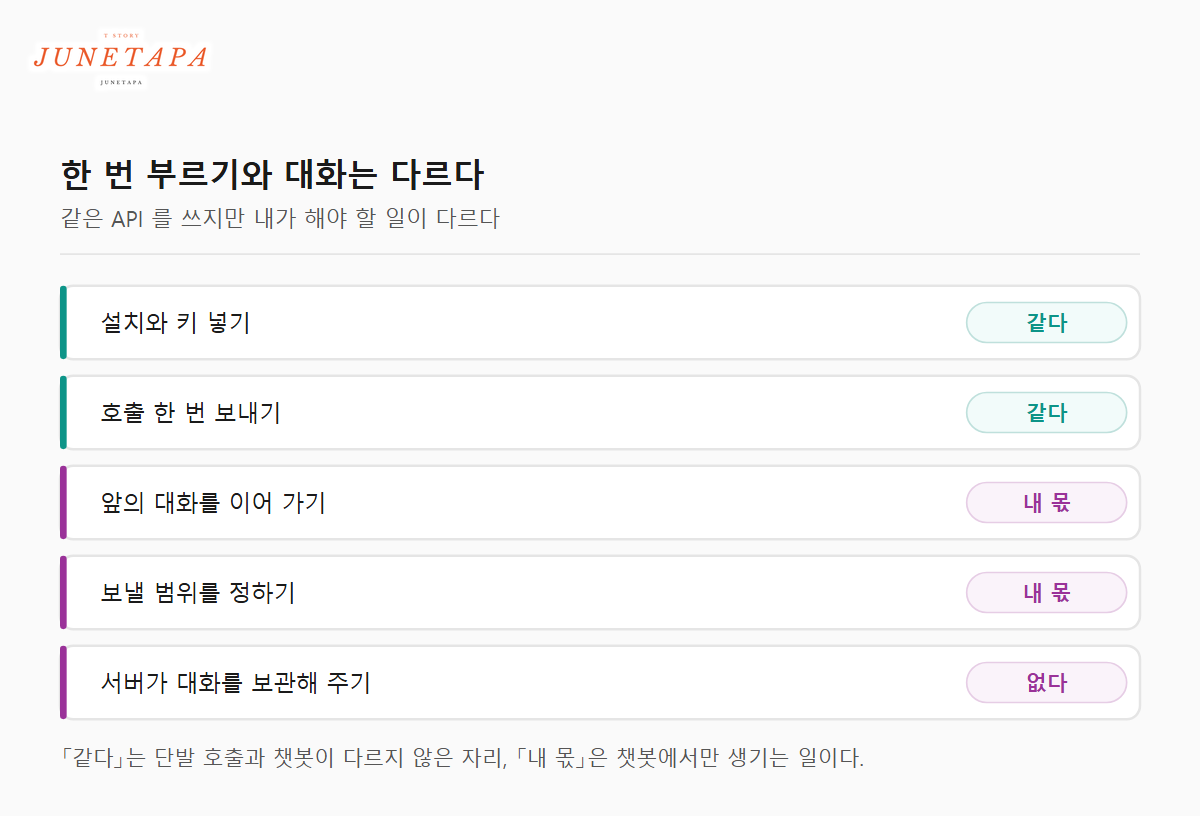
API로 모델을 한 번 부르는 것까지는 십 분이면 됩니다. 설치하고, 키를 넣고, 질문을 하나 던지면 답이 옵니다.
그런데 거기서 이어서 물어보면 곧바로 막힙니다. 방금 한 이야기를 모델이 기억하지 못합니다. 처음 만난 사람처럼 답합니다.
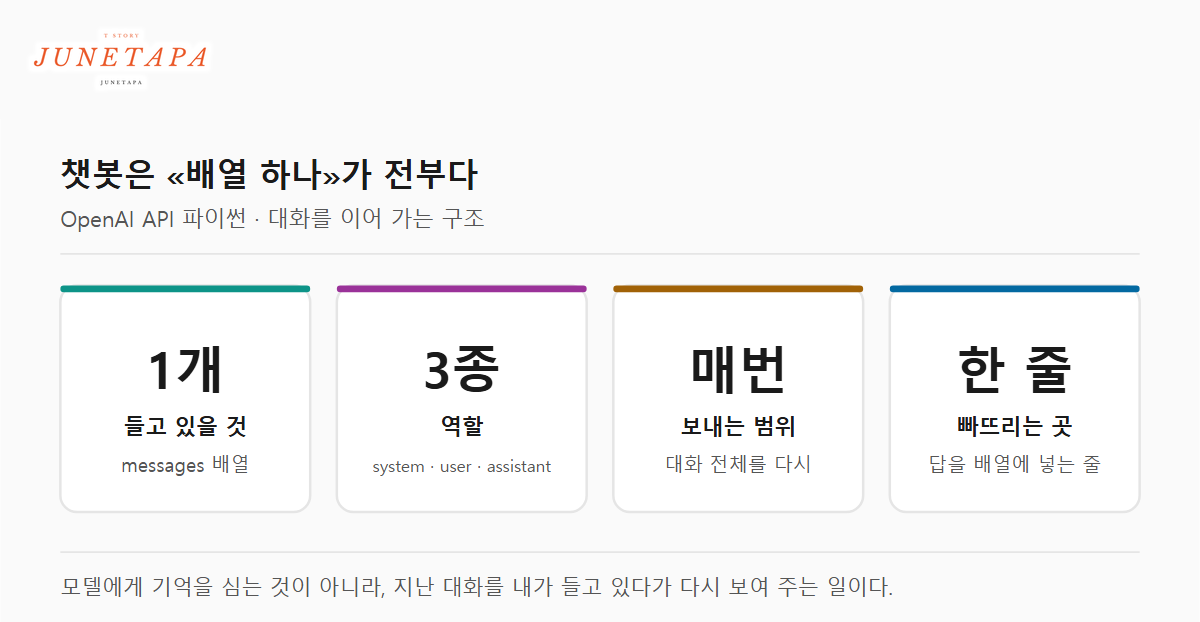
챗봇을 만든다는 건 모델에게 기억을 심는 일이 아닙니다. 지난 대화를 내가 들고 있다가 매번 다시 보여 주는 일입니다. 이 글은 그 한 가지를 다룹니다.
한 번 부르는 것까지는 십 분입니다
먼저 단발 호출입니다. 패키지를 깔고 키를 환경변수에 두면 끝입니다.
# pip install openai
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
MODEL = os.getenv("OPENAI_MODEL", "gpt-4o-mini")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "한 줄로 자기소개 해 줘"}],
)
print(resp.choices[0].message.content)
모델 이름을 코드에 박지 않고 환경변수로 뺀 이유가 있습니다. 모델 목록은 계속 바뀝니다. 값이 바뀌어도 코드를 고치지 않으려는 것입니다. 실제로 쓸 ID는 공식 문서의 최신 목록에서 고르면 됩니다.
여기까지는 다른 회사 API도 모양이 거의 같습니다. 같은 자리를 Anthropic SDK로 밟아 본 기록은 Claude API 파이썬 입문 편에 따로 적어 두었습니다.
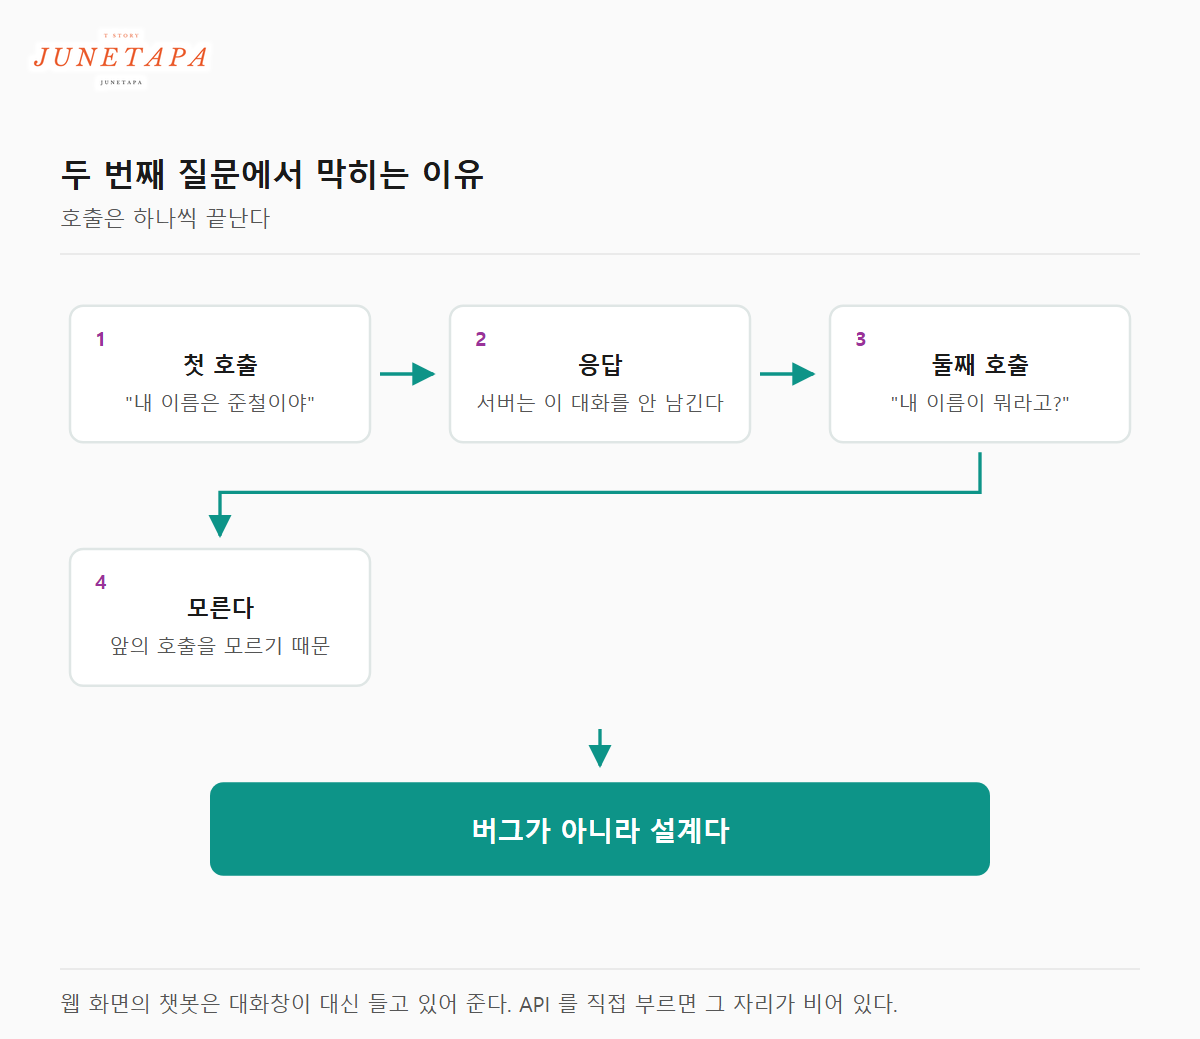
그런데 위 코드로 "내 이름은 준철이야"라고 보낸 뒤, 이어서 "내 이름이 뭐라고?"라고 물으면 모릅니다. 버그가 아닙니다.
API 호출은 한 번에 하나씩 끝나는 요청입니다. 서버가 나와의 대화를 따로 보관하지 않습니다. 각 호출은 앞의 호출을 모릅니다.
웹 화면에서 쓰는 챗봇과 헷갈리기 쉬운 지점입니다. 그쪽은 대화창이 대신 들고 있어 줍니다. API를 직접 부르면 그 역할을 맡아 줄 화면이 없습니다. 내가 그 자리를 채워야 합니다.
기억은 서버가 아니라 내 프로그램에 있습니다. 지난 대화를 배열에 쌓아 두었다가 다음 호출에 통째로 실어 보냅니다. 모델이 "기억하는" 것처럼 보이는 건 매번 전부 다시 읽고 있기 때문입니다.
챗봇의 전부는 «한 줄»입니다
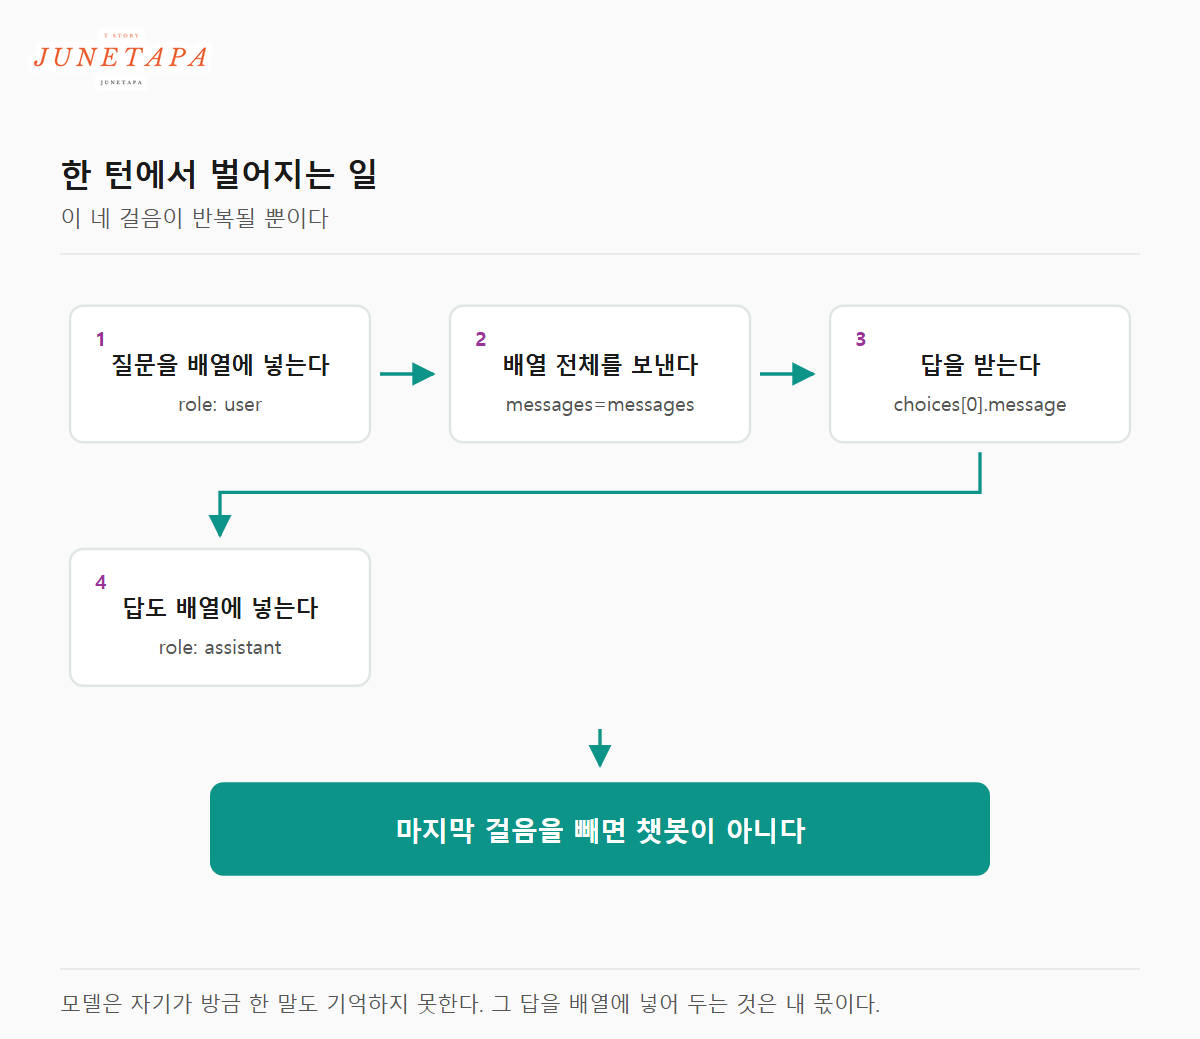
그래서 할 일은 하나뿐입니다. 답을 받으면 그 답도 배열에 넣어 두는 것입니다.
messages = [
    {"role": "system", "content": "너는 짧고 정확하게 답한다."}
]

while True:
    q = input("나 > ").strip()
    if not q:
        break

    messages.append({"role": "user", "content": q})

    resp = client.chat.completions.create(model=MODEL, messages=messages)
    answer = resp.choices[0].message.content

    messages.append({"role": "assistant", "content": answer})   # 이 줄이 챗봇의 전부다
    print("봇 >", answer)
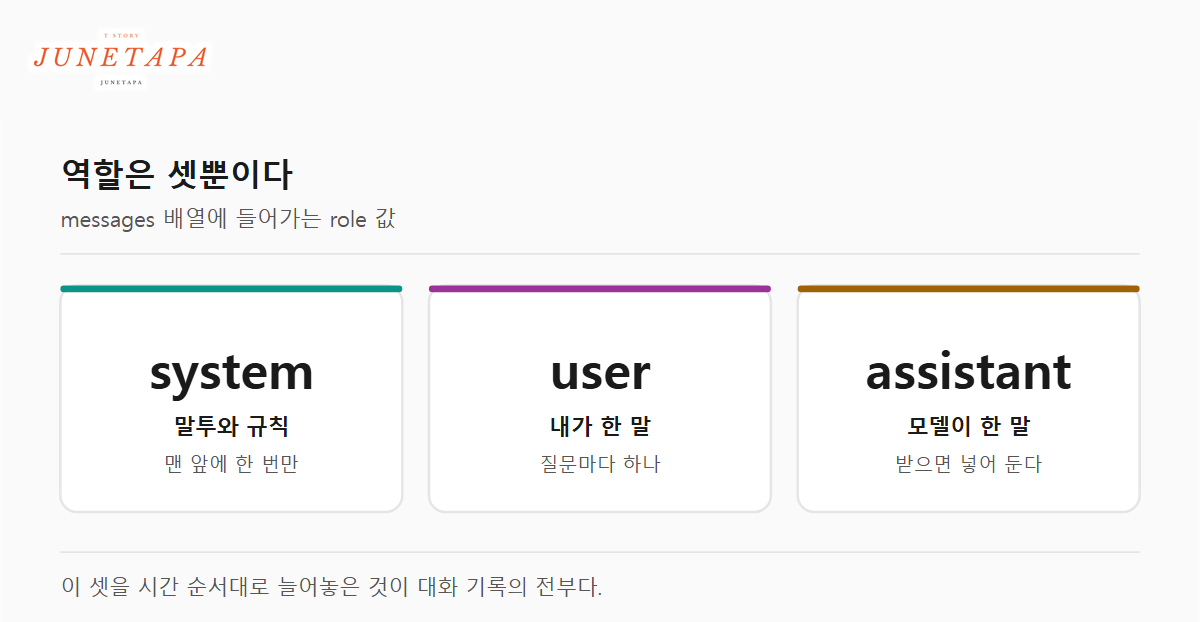
역할은 셋입니다. system은 말투와 규칙, user는 내 말, assistant는 모델이 한 말입니다. 마지막 줄을 빼면 모델은 자기가 방금 뭐라고 했는지도 모릅니다.
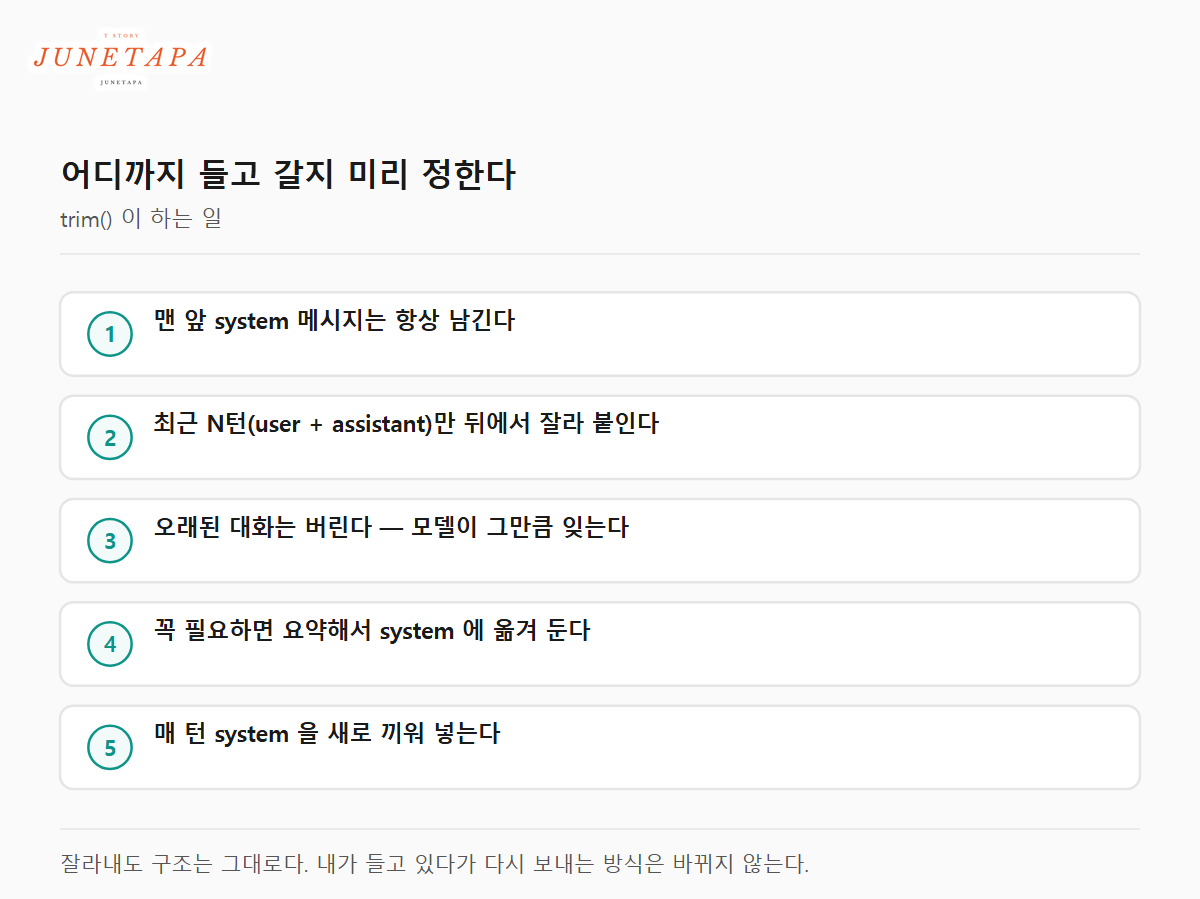
system 메시지는 맨 앞에 한 번만 둡니다. 매 턴 새로 끼워 넣으면 같은 지시가 여러 번 쌓여 토큰만 먹습니다.
대화가 길어지면 요금도 길어집니다
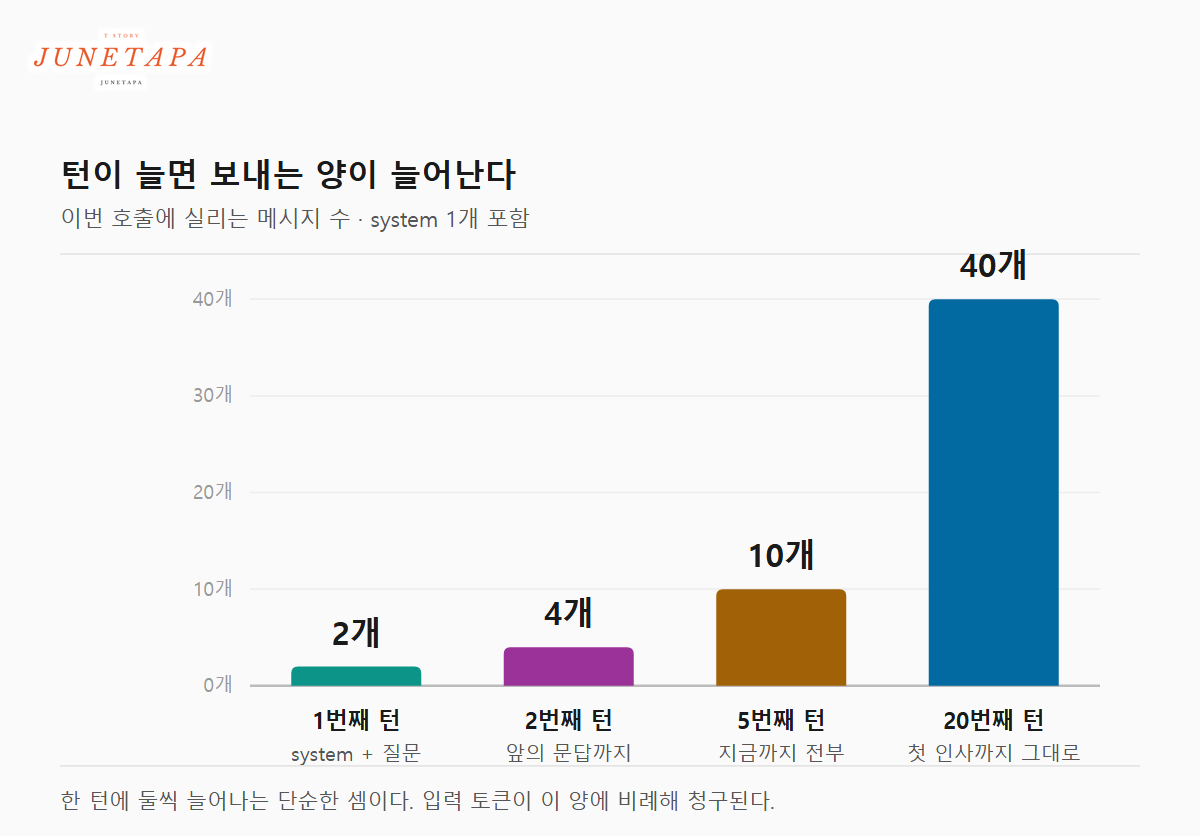
이 구조에는 대가가 따릅니다. 매 호출마다 대화 전체를 다시 보내기 때문에, 보내는 양이 턴마다 늘어납니다.
| 턴 | 이번 호출에 실리는 메시지 | 무엇이 실리나 |
|---|---|---|
| 1번째 | 2개 | system + 질문 1 |
| 2번째 | 4개 | 앞의 질문과 답 + 질문 2 |
| 5번째 | 10개 | 지금까지의 대화 전부 |
| 20번째 | 40개 | 첫 인사까지 그대로 |
한 턴에 메시지가 둘씩 늘어나는 단순한 셈입니다. 문제는 입력 토큰이 그 양에 비례해 청구된다는 점입니다. 20턴째의 짧은 질문 하나가, 앞선 열아홉 턴을 통째로 다시 실어 나릅니다.
짧게 몇 번 주고받는 정도면 이 비용은 눈에 띄지 않습니다. 문제가 되는 쪽은 오래 켜 두는 경우입니다. 하루 종일 창을 열어 둔 채 쓰면 배열이 계속 자라고, 어느 시점부터는 질문 자체보다 지난 대화가 더 비싸집니다.
어디까지 들고 갈지 미리 정합니다
해법은 간단합니다. 최근 몇 턴만 남기고 잘라 보냅니다. 시스템 메시지는 잘리지 않게 따로 뺍니다.
MAX_TURNS = 8          # 최근 8턴만 들고 간다

def trim(messages):
    system = messages[:1]                    # 맨 앞 system 은 고정
    rest = messages[1:]
    return system + rest[-MAX_TURNS * 2:]    # 한 턴 = user + assistant
여기에 재시도까지 붙이면 혼자 쓰기에는 충분합니다. 호출이 몰리면 RateLimitError가 납니다. 조금 기다렸다 다시 부르면 대개 지나갑니다.
import time
from openai import RateLimitError

def ask(messages, retries=2):
    for i in range(retries + 1):
        try:
            resp = client.chat.completions.create(
                model=MODEL,
                messages=trim(messages),      # 자른 것을 보낸다
            )
            return resp.choices[0].message.content
        except RateLimitError:
            if i == retries:
                raise
            time.sleep(2 ** i)                # 1초, 2초 쉬고 다시
잘라내면 오래된 이야기는 잊습니다. 그게 싫다면 요약해서 system 메시지에 넣는 방법이 있습니다. 다만 그것도 결국 «내가 들고 있다가 다시 보내는» 같은 방식입니다. 구조는 바뀌지 않습니다.
스트리밍, 함수 호출, 임베딩까지 한 번에 훑고 싶다면 OpenAI API 파이썬 챗봇 개발 완전 가이드에 항목별로 정리해 두었습니다.
자주 묻는 질문
Q. 대화를 파일이나 DB에 저장해도 되나요?
됩니다. 배열을 그대로 JSON으로 떨어뜨렸다가 다시 읽어 오면 어제 대화를 이어서 할 수 있습니다. 서버가 기억해 주지 않으니, 보관할 곳은 내가 정합니다.
Q. 답이 중간에 끊깁니다.
출력 길이 상한에 걸린 경우가 많습니다. 응답의 종료 사유를 먼저 확인하세요. 길이 때문이라면 상한을 올리거나, 질문을 나눠 던지는 편이 낫습니다.
Q. 키를 코드에 적어도 되나요?
동작은 합니다. 다만 그 파일을 어딘가에 올리는 순간 그대로 새어 나갑니다. 환경변수에 두는 습관이 결국 편합니다.
Q. 턴을 몇 개나 남기는 게 좋나요?
정답은 없습니다. 짧은 문답이면 8턴으로도 충분하고, 앞의 조건을 계속 참조해야 하는 작업이면 더 남겨야 합니다. 먼저 8로 두고, 모델이 앞을 놓칠 때 늘리는 순서가 편합니다.
Q. 여러 사람이 쓰는 챗봇이면 어떻게 하나요?
배열을 사람마다 따로 들고 있어야 합니다. 하나를 같이 쓰면 남의 대화가 섞여 들어갑니다. 사용자 ID를 열쇠로 삼아 각자의 배열을 꺼내 쓰는 식으로 갈라 두면 됩니다.
정리하면
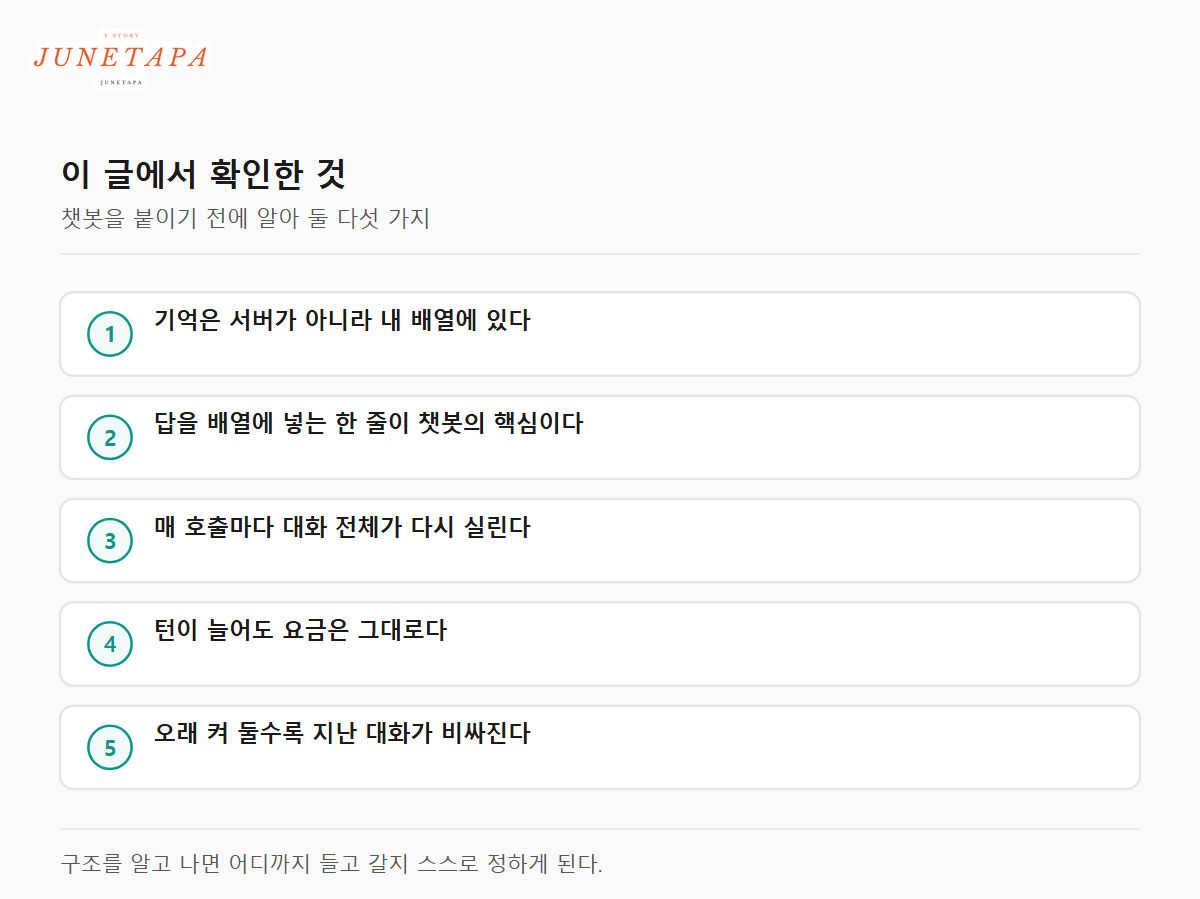
챗봇은 대단한 장치가 아닙니다. 배열 하나를 내가 들고 있는 것이 전부입니다. 답을 받으면 배열에 넣고, 다음 질문 때 통째로 다시 보냅니다.
그 사실을 알고 나면 요금도 예측이 됩니다. 대화가 길어질수록 보내는 양이 늘고, 그래서 어디까지 들고 갈지를 미리 정해 두게 됩니다.
스트리밍이나 함수 호출처럼 한 걸음 더 나가는 이야기는 완전 가이드 쪽에 모아 두었습니다.
※ 코드는 OpenAI 파이썬 SDK를 기준으로 적었습니다. 모델 ID와 요금은 시기에 따라 달라지므로 공식 문서에서 확인하세요.
'풀스택 개발이야기' 카테고리의 다른 글
| Kling AI로 영상 만들어 보기 — 입문자가 걸리는 다섯 자리 (0) | 2026.09.09 |
|---|---|
| MongoDB 실전 — NoSQL을 처음 쓸 때 헷갈리는 것 (1) | 2026.09.08 |
| 파이썬으로 만든 엑셀이 안 열린다 — 조용히 깨지는 네 자리 (0) | 2026.09.06 |
| Stable Diffusion을 내 PC에서 — 되는지부터 확인하는 법 (0) | 2026.09.05 |
| Django, Flask, FastAPI — 갈리는 건 성능이 아니라 «정해 주는 범위»다 (0) | 2026.09.04 |


